Dev Notes
Model Baru OpenAI & Anthropic Makin Murah: Waktunya Lu Audit Biaya API LLM
OpenAI dan Anthropic kompak pangkas harga token API. Saatnya tech lead dan engineer beralih ke arsitektur LLM yang hemat dan efisien.
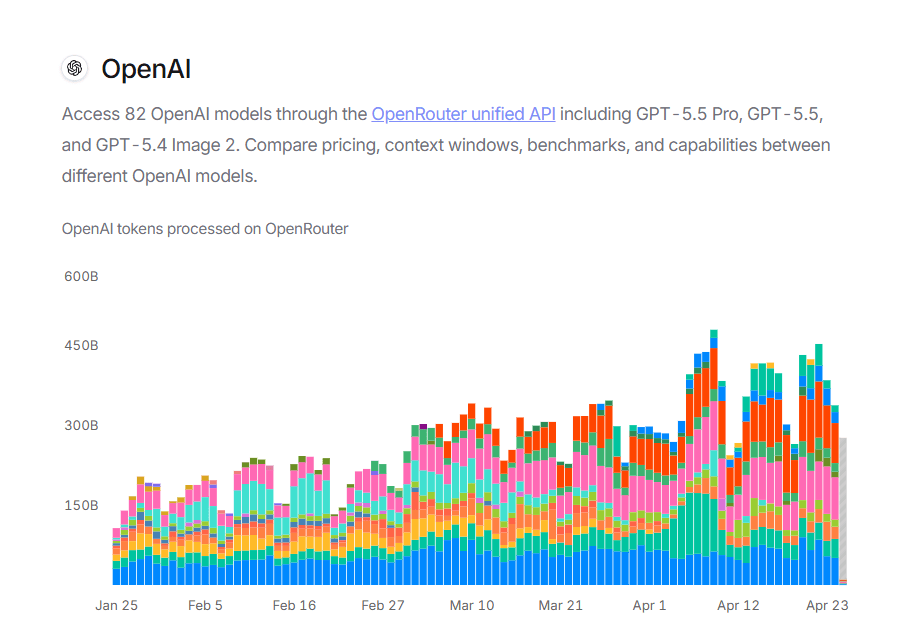
Berapa tagihan API LLM tim lu bulan lalu? Kalau lu masih pakai satu model frontier terberat dan termahal untuk semua endpoint—mulai dari ekstraksi JSON sederhana, klasifikasi sentimen, sampai agentic workflow yang kompleks—kemungkinan besar lu sedang membakar burn rate perusahaan secara cuma-cuma.
Kabar baiknya, peta persaingan provider AI mengalami pergeseran fundamental. OpenAI dan Anthropic kompak merilis lini model terbaru mereka dengan fokus utama yang bergeser: bukan lagi semata-mata adu skor benchmark teoritis, melainkan efisiensi biaya komputasi dan pemangkasan harga per token secara agresif. Performa model meningkat bertahap, tapi penurunan harganya sangat signifikan.
Ini sinyal penting bagi para tech lead, arsitek software, dan engineer: era "brute force" AI sudah selesai. Sekarang saatnya masuk ke era unit economics engineering—di mana efisiensi arsitektur dan optimasi cost per request menjadi pembeda antara fitur AI yang sustainable dengan proyek AI yang mati karena kehabisan anggaran cloud.
Pergeseran Paradigma: Kenapa Efisiensi Token Menjadi Kunci?
Dua tahun lalu, perlombaan LLM didominasi oleh siapa yang bisa membuat model dengan parameter terbesar dan penalaran paling mutakhir, tanpa peduli seberapa mahal harga inference-nya. Pola ini masuk akal pada tahap riset awal. Namun, ketika integrasi AI mulai masuk ke lingkungan produksi dengan jutaan monthly active users (MAU), pricing model lama langsung menghantam gross margin produk perangkat lunak.
Penurunan harga token dari OpenAI dan Anthropic menegaskan satu hal: kecerdasan mesin sedang mengalami komoditisasi cepat. Nilai tambah sebuah produk perangkat lunak bukan lagi terletak pada provider mana yang lu panggil lewat HTTP request, melainkan:
- Routing Logic yang Cerdas: Mampu mengarahkan request ke model termurah yang masih memenuhi standar kualitas task tersebut.
- Context Window Hygiene: Membersihkan noise, boilerplate, dan token yang tidak perlu sebelum dikirim ke API.
- Resilience & Vendor Independence: Kemampuan beralih antar provider tanpa merombak business logic inti.
Kalau kode aplikasi lu masih dipenuhi hardcoded string nama model termahal di berbagai service, saatnya melakukan audit menyeluruh.
Langkah 1: Observability & Audit — Lu Gak Bisa Hemat Kalau Gak Bisa Ukur
Banyak tim tidak menyadari kebocoran biaya mereka karena metrik yang dicatat hanya sebatas status latency HTTP (200 OK vs 500 Error). Metrik token usage sering kali diabaikan dan dibiarkan tenggelam dalam response payload.
Langkah pertama adalah membangun middleware telemetri yang menghitung estimasi biaya per transaksi secara real-time dan melampirkannya ke sistem logging atau APM (Application Performance Monitoring) lu.
Berikut adalah contoh implementasi wrapper client TypeScript yang membungkus pemanggilan LLM dengan kalkulasi token dan metadata biaya:
// telemetry-llm-client.ts
import { OpenAI } from "openai";

interface TokenPricing {
  inputPerMillion: number;
  outputPerMillion: number;
}

// Konfigurasi harga per 1M token (disesuaikan dengan tier model)
const MODEL_PRICING_TABLE: Record<string, TokenPricing> = {
  "gpt-frontier-efficient": { inputPerMillion: 2.5, outputPerMillion: 10.0 },
  "gpt-lightweight": { inputPerMillion: 0.15, outputPerMillion: 0.6 },
  "claude-frontier-efficient": { inputPerMillion: 3.0, outputPerMillion: 15.0 },
  "claude-lightweight": { inputPerMillion: 0.25, outputPerMillion: 1.25 },
};

export interface MonitoredLLMRequest {
  featureName: string;
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  temperature?: number;
}

export interface MonitoredLLMResponse {
  content: string | null;
  usage: {
    promptTokens: number;
    completionTokens: number;
    totalTokens: number;
    estimatedCostUSD: number;
  };
}

export class AuditedLLMGateway {
  private client: OpenAI;

  constructor(apiKey: string, baseURL?: string) {
    this.client = new OpenAI({ apiKey, baseURL });
  }

  public async complete(request: MonitoredLLMRequest): Promise<MonitoredLLMResponse> {
    const startTime = performance.now();

    const response = await this.client.chat.completions.create({
      model: request.model,
      messages: request.messages,
      temperature: request.temperature ?? 0.7,
    });

    const durationMs = performance.now() - startTime;
    const usage = response.choices[0]?.message;
    const tokenUsage = response.usage;

    const promptTokens = tokenUsage?.prompt_tokens ?? 0;
    const completionTokens = tokenUsage?.completion_tokens ?? 0;
    const totalTokens = tokenUsage?.total_tokens ?? 0;

    // Kalkulasi biaya berdasarkan pricing table
    const pricing = MODEL_PRICING_TABLE[request.model] ?? { inputPerMillion: 0, outputPerMillion: 0 };
    const inputCost = (promptTokens / 1_000_000) * pricing.inputPerMillion;
    const outputCost = (completionTokens / 1_000_000) * pricing.outputPerMillion;
    const estimatedCostUSD = inputCost + outputCost;

    // Log structured event untuk dashboard observability
    console.info(
      JSON.stringify({
        event: "llm_call_telemetry",
        feature: request.featureName,
        model: request.model,
        durationMs: Math.round(durationMs),
        promptTokens,
        completionTokens,
        totalTokens,
        estimatedCostUSD: Number(estimatedCostUSD.toFixed(6)),
        timestamp: new Date().toISOString(),
      })
    );

    return {
      content: usage?.content ?? null,
      usage: {
        promptTokens,
        completionTokens,
        totalTokens,
        estimatedCostUSD,
      },
    };
  }
}
Penjelasan Baris demi Baris:
- Interface `TokenPricing` & `MODEL_PRICING_TABLE`: Mengisolasi data tarif per 1 juta token. Ketika OpenAI atau Anthropic menurunkan harga, lu cukup mengubah satu titik konfigurasi tanpa menyentuh logic aplikasi.
- Method `complete()`: Menghitung durasi latensi eksekusi dan mengekstrak objek
usagebawaan dari response provider. - Kalkulasi Biaya Terisolasi: Menghitung biaya input dan output secara terpisah, karena harga output tokens pada umumnya 3x sampai 5x lebih mahal daripada input tokens.
- Structured JSON Log: Format log terstruktur memudahkan sistem seperti Datadog, Grafana Loki, atau CloudWatch mengagregasi total pengeluaran per nama fitur (
featureName).
Tips Praktis: Jangan cuma mengelompokkan metrik per model. Selalu lampirkan labelfeatureName(misalnya:invoice-parser,support-chatbot,code-reviewer). Dengan begitu, lu bisa langsung tahu fitur mana yang menjadi kontributor tagihan terbesar.
Langkah 2: Multi-Tier Model Routing (Stop Pakai Model Termahal Buat Semuanya)
Kesalahan arsitektur paling umum adalah mengasumsikan seluruh interaksi user membutuhkan kapasitas deep reasoning. Faktanya, lebih dari 60% pemanggilan LLM di lingkungan produksi adalah tugas mekanis: parsing teks, klasifikasi intent, transformasi JSON, atau formatting.
Gunakan pendekatan Tiered Routing:
- Tier 1 (Fast & Ultra-Cheap): Model ringan untuk ekstraksi data terstruktur, intent classification, dan guardrails validation.
- Tier 2 (Balanced Production): Model efisiensi menengah untuk penulisan konten standar, ringkasan teks panjang, dan conversational agents.
- Tier 3 (Frontier Reasoning): Model kelas berat khusus untuk complex code synthesis, multi-step math reasoning, dan analisis multi-dokumen yang kritis.
Berikut implementasi Task Router yang mendistribusikan workload berdasarkan kategori kebutuhan task:
// dynamic-router.ts
import { AuditedLLMGateway, MonitoredLLMResponse } from "./telemetry-llm-client";

export type TaskComplexity = "simple_extraction" | "general_chat" | "deep_reasoning";

export interface ExecutionPayload {
  featureName: string;
  complexity: TaskComplexity;
  systemPrompt: string;
  userPrompt: string;
}

export class DynamicModelRouter {
  private gateway: AuditedLLMGateway;

  constructor(gateway: AuditedLLMGateway) {
    this.gateway = gateway;
  }

  private resolveModelName(complexity: TaskComplexity): string {
    switch (complexity) {
      case "simple_extraction":
        // Gunakan model efisiensi tinggi / lightweight
        return "gpt-lightweight";
      case "general_chat":
        // Gunakan model kelas menengah yang baru dan murah
        return "gpt-frontier-efficient";
      case "deep_reasoning":
        // Cadangkan model frontier berharga premium hanya saat mutlak dibutuhkan
        return "claude-frontier-efficient";
      default:
        return "gpt-lightweight";
    }
  }

  public async executeTask(payload: ExecutionPayload): Promise<MonitoredLLMResponse> {
    const selectedModel = this.resolveModelName(payload.complexity);

    try {
      return await this.gateway.complete({
        featureName: payload.featureName,
        model: selectedModel,
        messages: [
          { role: "system", content: payload.systemPrompt },
          { role: "user", content: payload.userPrompt },
        ],
        temperature: payload.complexity === "simple_extraction" ? 0.0 : 0.7,
      });
    } catch (error) {
      console.error(`Gagal mengeksekusi dengan ${selectedModel}, mengalihkan ke fallback...`, error);

      // Fallback resilience: jika model primary gagal, route ke model lightweight alternatif
      return await this.gateway.complete({
        featureName: `${payload.featureName}_fallback`,
        model: "claude-lightweight",
        messages: [
          { role: "system", content: payload.systemPrompt },
          { role: "user", content: payload.userPrompt },
        ],
      });
    }
  }
}
Penjelasan Baris demi Baris:
- Type `TaskComplexity`: Memisahkan level tugas ke dalam tiga kategori eksplisit sehingga developer tidak memilih nama model secara manual di frontend atau controller.
- Method `resolveModelName()`: Memetakan kompleksitas tugas ke model yang paling efisien secara biaya. Jika vendor merilis model baru yang lebih murah, mapping ini tinggal diperbarui di satu berkas.
- Dynamic Temperature Tuning: Menurunkan
temperatureke0.0pada simple_extraction untuk mendapatkan hasil deterministik tanpa menghabiskan token untuk variasi respon. - Fallback Mechanism: Blok
catchmenyediakan jalur otomatis ke provider alternatif jika model utama mengalami rate limit atau outage.
Langkah 3: Prompt Engineering & Context Compaction
Model baru yang lebih murah bukan alasan untuk membuang-buang token. Banyak aplikasi mengirimkan seluruh chat history (bisa mencapai puluhan turn) setiap kali user mengirimkan satu kalimat pendek. Ini adalah pemborosan token masif.
Gunakan teknik Sliding Window Token Truncation dan pembersihan redundancy pada context window:
// context-optimizer.ts
export interface ChatMessage {
  role: "system" | "user" | "assistant";
  content: string;
}

export class ContextOptimizer {
  // Estimasi kasar: 1 token ~ 4 karakter teks latin
  private static estimateTokenCount(text: string): number {
    return Math.ceil(text.length / 4);
  }

  public static pruneHistory(
    messages: ChatMessage[],
    maxContextTokens: number = 2000
  ): ChatMessage[] {
    const systemMessages = messages.filter((m) => m.role === "system");
    const nonSystemMessages = messages.filter((m) => m.role !== "system");

    let currentTokens = systemMessages.reduce(
      (sum, msg) => sum + this.estimateTokenCount(msg.content),
      0
    );

    const retainedMessages: ChatMessage[] = [];

    // Iterasi dari percakapan terbaru mundur ke belakang
    for (let i = nonSystemMessages.length - 1; i >= 0; i--) {
      const msg = nonSystemMessages[i];
      const tokens = this.estimateTokenCount(msg.content);

      if (currentTokens + tokens > maxContextTokens) {
        break; // Stop jika batas kapasitas context window tercapai
      }

      currentTokens += tokens;
      retainedMessages.unshift(msg);
    }

    return [...systemMessages, ...retainedMessages];
  }
}
Penjelasan Baris demi Baris:
- Pemisahan `systemMessages`: System prompt adalah instruksi paling penting yang menentukan aturan operasional model, sehingga wajib dipertahankan seluruhnya.
- Iterasi Terbalik (Reverse Traversal): Memulai pemindaian dari pesan paling baru (
nonSystemMessages.length - 1). Konteks paling baru memiliki relevansi tertinggi bagi respon model berikutnya. - Batas `maxContextTokens`: Memotong riwayat lama yang sudah tidak relevan sebelum payload dikirim ke jaringan, menghemat ribuan token input per transaksi.
Langkah 4: Circuit Breaker & Budget Guardrails
Bencana tagihan AI sering terjadi bukan karena pemakaian normal, melainkan akibat infinite loop pada autonomous agents atau scraping bot yang mengeksploitasi endpoint publik lu.
Kita membutuhkan proteksi di tingkat proxy: Budget Circuit Breaker yang otomatis menolak eksekusi jika kuota pengeluaran telah melampaui batas keamanan.
Berikut contoh implementasi Spend Guardrail:
// budget-guardrail.ts
export class DailySpendGuardrail {
  private dailyBudgetUSD: number;
  private currentSpentUSD: number = 0;
  private resetDate: string;

  constructor(dailyBudgetUSD: number) {
    this.dailyBudgetUSD = dailyBudgetUSD;
    this.resetDate = new Date().toISOString().slice(0, 10);
  }

  private checkAndResetWindow(): void {
    const today = new Date().toISOString().slice(0, 10);
    if (today !== this.resetDate) {
      this.currentSpentUSD = 0;
      this.resetDate = today;
    }
  }

  public assertBudgetAvailable(): void {
    this.checkAndResetWindow();
    if (this.currentSpentUSD >= this.dailyBudgetUSD) {
      throw new Error(
        `[CIRCUIT_BREAKER_TRIGGERED] Daily LLM budget limit reached ($${this.dailyBudgetUSD}). Request blocked.`
      );
    }
  }

  public recordExpense(costUSD: number): void {
    this.checkAndResetWindow();
    this.currentSpentUSD += costUSD;
    console.info(`[BUDGET_TRACKER] Total spent today: $${this.currentSpentUSD.toFixed(4)} / $${this.dailyBudgetUSD}`);
  }
}
Penjelasan Baris demi Baris:
- State `dailyBudgetUSD` & `currentSpentUSD`: Menyimpan batas pengeluaran harian dan melacak akumulasi biaya yang telah terpakai.
- Method `checkAndResetWindow()`: Mereset counter pengeluaran setiap kali pergantian hari UTC secara otomatis.
- Method `assertBudgetAvailable()`: Bertindak sebagai fail-fast barrier. Jika kuota harian telah habis, request langsung dibatalkan sebelum network request ke API LLM sempat dibuat.
- Method `recordExpense()`: Mengakumulasi biaya riil pasca-eksekusi berdasarkan metrik yang dikembalikan oleh telemetry gateway.
Checklist Praktis: Audit Biaya LLM Minggu Ini
Untuk mulai menerapkan efisiensi biaya di codebase tim lu, gunakan checklist tindakan berikut:
- Ganti *Hardcoded* Model Name: Ekstraksi semua nama model dari kode aplikasi ke dalam satu file konfigurasi centralized atau environment variables.
- Implementasikan Model Tiering: Pisahkan endpoint ekstraksi JSON sederhana agar menggunakan model kelas lightweight.
- Aktifkan Prompt Caching: Manfaatkan fitur caching dari provider untuk system prompt berukuran besar yang jarang berubah.
- Pasang Context Truncator: Batasi panjang message history pada conversational features menggunakan sliding window.
- Set Hard Limits & Alerts: Aktifkan limit bulanan langsung pada dashboard OpenAI dan Anthropic, lalu buat notifikasi Discord/Slack saat penggunaan mencapai 80%.
Kesimpulan: Efisiensi adalah Keunggulan Kompetitif
Perang harga antara OpenAI dan Anthropic adalah berkah bagi developer dan startup. Penurunan biaya token membuka pintu untuk fitur-fitur baru yang sebelumnya dinilai terlalu mahal untuk diproduksi.
Namun, provider yang makin murah bukan kartu bebas hambatan untuk menulis kode yang boros. Tim engineering yang paling unggul di era AI bukanlah tim yang sekadar menyambungkan model termahal, melainkan tim yang mampu membangun arsitektur komputasi cerdas, terukur, dan efisien secara ekonomi.
Audit kode lu sekarang, pasang observability, dan pastikan setiap token yang lu bayar memberikan nilai bisnis yang sepadan.
Sumber
- https://arstechnica.com/ai/2026/09/new-anthropic-openai-models-make-same-promise-a-little-more-for-a-lot-less-money/
- https://www.engadget.com/2265801/anthropic-and-openai-announce-more-powerful-and-cheaper-ai-models/
Butuh penyesuaian khusus untuk project Anda?
Jika situasi operasional atau arsitektur sistem bisnis Anda membutuhkan solusi kustom, diskusikan langsung bersama tim engineer kami. Anda juga bisa melihat rincian layanan vour.dev atau menghitung estimasi biaya project lebih dulu.
Mulai Project